Kurzfassung
AI-Agenten lernen nicht mehr nur in Modellgewichten. Lernen verteilt sich auf Kontext, Memory, Tool-Policies, Execution Traces, Verifier und Harness-Code. Die technische Frage verschiebt sich deshalb: Nicht nur welches Modell ist besser, sondern wo lebt die Anpassung?
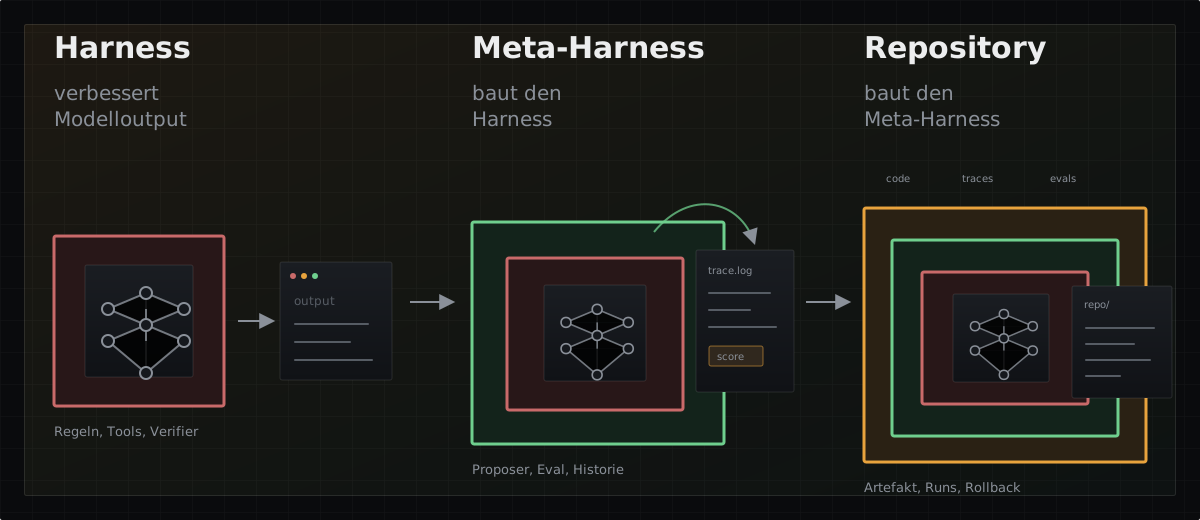
Ein Harness ist die technische Schicht, die ein Modell mit Aufgabe, Kontext, Tools, Ausführung, Logging und Bewertung verbindet. Ein Meta-Harness optimiert diese Schicht selbst. Er sucht nicht nur nach besseren Antworten, sondern nach besseren Regeln dafür, was das Modell sieht, welche Aktionen erlaubt sind, welche Erfahrungen gespeichert werden und welche Fehler beim nächsten Lauf noch nachwirken.
Das ist mehr als Prompt Engineering — und die Idee ist älter, als sie aussieht. Die Meta-Learning-Tradition seit 1987 träumte von Systemen, die ihre eigene Lernprozedur umschreiben. MAML und RL² zeigen die klassische Form: Langsames Training erzeugt schnelle Anpassung. In-Context-Learning verschiebt einen Teil dieser Anpassung in den Forward Pass. Memory-Systeme speichern Erfahrung außerhalb der Gewichte. Sleep-Time Compute und Machine Studying verlagern Arbeit in die Zeit vor der Anfrage. AutoHarness und Meta-Harness machen schließlich den Systemcode selbst zum Lernobjekt — und lösen damit das alte Versprechen der Selbstmodifikation in inspizierbarer Form ein: als Code-Diff mit Trace-Log statt als versteckte Aktivierung.
Die offene Frage lautet: Will the model eat the harness? Wenn der Harness nur kompensiert, was heutige Modelle noch nicht können, wird ein stärkeres Modell Teile davon schlucken. Wenn der Harness aber die Schicht für Rechte, Ausführung, Verifikation, Memory, Kostenkontrolle und Auditierbarkeit bleibt, wird er nicht gefressen. Dann wird er zum Langzeitgedächtnis und Kontrollsystem des Agenten — und überlebt jede einzelne Modellgeneration.
1. Die falsche Einheit
Die alte Basiseinheit war der einzelne Modellaufruf: ein Modell verarbeitet eine Eingabe und erzeugt eine Antwort. Für heutige Agenten ist diese Einheit zu grob.
Ein moderner Coding-Agent besteht nicht nur aus einem Sprachmodell. Er bekommt ein Repository, durchsucht Dateien, ruft Tests auf, liest Fehlermeldungen, schreibt Patches, verwirft Zwischenergebnisse, speichert Notizen und entscheidet, wann eine Aufgabe fertig ist. Die Modellgewichte sind nur ein Teil der Maschine. Der Rest entscheidet, welche Handlung möglich, messbar und wiederholbar wird.
Die Berkeley-These zu Compound AI Systems beschreibt diese Verschiebung auf Systemebene: Führende AI-Ergebnisse entstehen zunehmend durch mehrere interagierende Komponenten, nicht durch einen einzelnen Modellaufruf. Retriever, Tools, symbolische Solver, Filter, Verifier und Custom Logic werden Teil der Leistung.1
Das verändert auch die Frage nach Lernen. Wenn ein System besser wird, kann der Fortschritt an mehreren Orten liegen:
| Ort des Lernens | Form | Beispiel | Grenze |
|---|---|---|---|
| Gewichte | Parameterupdate | MAML, RL, LoRA-Finetuning | teuer, schwer auditierbar |
| Aktivierungen | temporärer Zustand | RL², rekurrente Tiefe in LoopLM | verschwindet nach Reset |
| Kontext | In-Context-Learning | Transformer als innerer Optimierer | flüchtig, teuer, anfällig für Context Rot |
| Memory | persistente Token-Artefakte | MemGPT, SimpleMem, Memory Models | Memory Formation ist schwer |
| Harness | Code, Tools, Verifier, Logs | AutoHarness, Meta-Harness | Overfitting und Safety-Fragen |
Die stärkere These lautet deshalb nicht: Systeme werden wichtiger als Modelle. Das ist zu allgemein. Die stärkere These lautet: Lernen hat keinen festen Speicherort mehr.
2. Lernen in Gewichten
Meta-Learning ist keine neue Idee. Schmidhuber datiert selbstreferenzielles Lernen auf 1987 und verfolgt seither die radikale Version: Systeme, die nicht nur lernen, sondern ihre eigene Lernprozedur verbessern — bis hin zur Gödel Machine, die ihren eigenen Code umschreibt, nachdem sie den Nutzen der Änderung bewiesen hat.2 Diese Tradition blieb lange theoretisch. Aber sie formuliert den Anspruch, an dem sich heutige Systeme messen lassen müssen: nicht Transfer Learning, sondern Selbstmodifikation (self-modification).
Die moderne, praktische Form begann bescheidener: Modelle so trainieren, dass sie später schneller lernen.
MAML formuliert diese Idee sauber. Das Verfahren trainiert keine endgültige Lösung, sondern eine Initialisierung. Nach wenigen Gradienten-Schritten auf einer neuen Aufgabe soll das Modell gut generalisieren. Die äußere Optimierung belohnt also Anpassbarkeit, nicht statische Leistung.3
RL² überträgt dieselbe Logik ins Reinforcement Learning. Ein rekurrenter Agent erhält Beobachtungen, Aktionen, Rewards und Termination Flags. Sein Hidden State bleibt über mehrere Episoden derselben Aufgabe erhalten. Die langsame äußere RL-Schleife trainiert die Gewichte; die schnelle innere Anpassung läuft in den Aktivierungen.4
Beide Arbeiten machen denselben Schnitt sichtbar: Langsames Training erzeugt eine Struktur, die sich auf neuen Aufgaben schnell anpasst (fast adaptation).
Der Lernort bleibt aber noch nah am Modell. Bei MAML liegt er in einer guten Initialisierung. Bei RL² liegt er in den rekurrenten Aktivierungen. Das ist elegant, aber schwer zu inspizieren. Wenn RL² auf einer neuen Aufgabe lernt, sieht man kein Memory-Dokument, keinen Code-Diff und keine Fehlerdatenbank. Die Anpassung verschwindet, wenn der Zustand zurückgesetzt wird.
Für agentische Systeme ist das zu wenig. Ein Coding-Agent soll nicht nur während eines Rollouts klüger werden. Er soll Erfahrungen behalten, Fehler wiedererkennen und seine Arbeitsweise ändern. Dafür braucht Lernen einen dauerhafteren Träger. Die Schmidhuber-Linie kehrt am Ende dieses Textes zurück — auf der Harness-Ebene, wo Selbstmodifikation zum ersten Mal inspizierbar wird.
3. Lernen im Kontext
In-Context-Learning war der nächste Ortswechsel. Das Modell ändert seine Gewichte nicht, passt sein Verhalten aber an Beispiele, Instruktionen und Daten im Prompt an.
Eine mechanistische Interpretation geht der Frage nach, was dabei im Inneren des Modells passiert — und die Antwort ist überraschend konkret. Gradientenabstieg (gradient descent) ist das Standardverfahren, mit dem man ein Modell trainiert: Man verbessert es Schritt für Schritt anhand seiner Fehler. In kontrollierten Regressionsaufgaben lässt sich nun zeigen, dass eine einzelne lineare Self-Attention-Schicht rechnerisch genau einen solchen Trainingsschritt nachbildet — ausgeführt allein im Forward Pass, ohne dass sich ein einziges Gewicht ändert. Das Modell trainiert also gewissermaßen ein Miniaturmodell in sich selbst, nur aus den Beispielen im Prompt. Stapelt man mehrere Schichten, entspricht das mehreren Trainingsschritten hintereinander; das Modell lernt dabei sogar Verfeinerungen, die schneller zum Ziel führen als naiver Gradientenabstieg.5
Das ist kein Beweis, dass jedes Sprachmodell bei jeder Aufgabe innerlich Gradientenabstieg macht. Die Experimente sind enger. Aber die Architekturfrage wird schärfer: Kontext ist nicht nur ein Speicher, den das Modell liest. Kontext kann ein Arbeitsmedium sein, in dem das Modell eine temporäre Lernprozedur ausführt.
Für Harnesses ist das entscheidend. Wer den Kontext baut, baut nicht nur eine Eingabe. Er baut die Datenstruktur, auf der der innere Lernmechanismus des Modells operiert. Ein Prompt, eine Retrieval-Liste oder eine Trace-History sind deshalb nicht neutral. Sie definieren, welche schnelle Anpassung überhaupt möglich wird.
Das erklärt auch, warum mehr Kontext allein nicht ausreicht. Ein langer Kontext kann nützlich sein, wenn er die richtige Struktur hat. Er kann schaden, wenn er irrelevante Zwischenschritte, widersprüchliche Notizen oder alte Fehler mitschleppt. Der relevante Engpass ist nicht nur Kontextlänge. Es ist Kontextform.
4. Lernen in Memory
Memory verschiebt Lernen aus dem aktuellen Prompt in persistenten Zustand.
MemGPT formulierte dafür eine Betriebssystem-Metapher. Das Modell hat ein knappes Arbeitsgedächtnis, externe Speicher und Funktionen, um Informationen zwischen diesen Schichten zu verschieben. Kontextfenster werden wie physischer Speicher behandelt; Recall und Archival Storage übernehmen die Rolle externer Speicher.6
SimpleMem macht daraus eine praktische Pipeline: Erinnerung ist nicht alles, was passiert ist. Erinnerung ist Auswahl, Kompression, Konsolidierung und spätere Retrieval-Policy. Eingehende Dialoge werden nach semantischer Dichte gefiltert und zu kompakten, kontextunabhängigen Memory-Einheiten umgeschrieben; verwandte Einheiten werden schon beim Schreiben konsolidiert. Auf LoCoMo verbessert das den F1-Score um 26 Prozent gegenüber starken Baselines — bei bis zu 30-fach geringerem Token-Verbrauch pro Anfrage.7 Ein gutes Memory-System speichert nicht den vollständigen Verlauf, sondern die Einheit, die künftige Aufgaben billiger und robuster macht.
EvolveMem geht einen Schritt weiter: Nicht nur die Inhalte, auch die Retrieval-Infrastruktur selbst wird zum Lernobjekt. Ein Diagnose-Modul liest Fehlerlogs pro Frage, identifiziert Ursachen und schlägt gezielte Konfigurationsänderungen vor — abgesichert durch einen Guard, der Verschlechterungen automatisch zurückrollt. Das System startet mit reinem BM25-Retrieval und erfindet selbstständig semantische Suche, Query-Dekomposition und Answer Verification; in sieben Runden steigt der F1-Score von 30,5 auf 54,3 Prozent.8 Der Kerngedanke in einem Satz: Ein Memory-System sollte sich erinnern, wie es sich nicht erinnern konnte.
Die Letta-These zu Memory Models zieht die strategische Konsequenz. Allgemeine LLMs können Kontext gut nutzen, erzeugen aber nicht zuverlässig dauerhaften Kontext (durable context). Ein Memory Model wäre ein spezialisiertes Modell, das Erinnerung im Token-Raum (token-space memory) erzeugt und kuratiert. Diese Erinnerung hat eine bemerkenswerte ökonomische Eigenschaft: Das Frontier-Modell ist ein an Wert verlierender Vermögenswert (depreciating asset) — es wird ersetzt. Die akkumulierte Aufgaben-, Nutzer- und Organisationserinnerung ist ein an Wert gewinnender Vermögenswert (appreciating asset) — sie bleibt. Letta nennt den Grund die bitter lesson of ICL: Weil jede Modellgeneration gespeicherten Kontext wirksamer auswertet als die vorige, gewinnt dieselbe Erinnerung mit jedem Modellwechsel automatisch an Wert.9
Wie trainiert man ein solches Memory Model? Der Begriff, den Letta dafür einführt, schlägt die Brücke zurück zu MAML und RL²: memory-native RL. Herkömmliches Reinforcement Learning (standard RL) optimiert ein Modell direkt auf den Aufgaben-Reward; gelernt wird im Gewichtsraum (weight space). Memory-native RL verschiebt das Ziel: Optimiert wird ein Verbundsystem (compound system), in dem ein Memory Model über eine offene Folge von Aufgaben hinweg Erinnerung im Token-Raum schreibt und pflegt. Die innere Schleife handelt anhand dieser Erinnerung; die äußere Schleife belohnt nicht die einzelne Aufgabe, sondern die künftige Leistung, die aus den erzeugten Erinnerungen folgt. Es ist derselbe Schnitt wie bei MAML — langsames Außen, schnelles Innen —, nur wandert die schnelle Anpassung aus den flüchtigen Aktivierungen in dauerhaften Token-Raum. Meta-Learning im Token-Raum, im Wortsinn.9
Damit wird Memory selbst zu einer Lernschicht:
| Speicherform | Was bleibt? | Was wird gelernt? |
|---|---|---|
| Chat-Verlauf | Rohinteraktion | wenig, oft nur Wiederholung |
| Zusammenfassung | verdichtete Fakten | was später wahrscheinlich relevant ist |
| Skill-Datei | Vorgehensweise | wie ähnliche Aufgaben gelöst werden |
| Tool-Policy | Handlungskontrolle | wann welche Aktion erlaubt oder sinnvoll ist |
| Retrieval-Konfiguration | Zugriffsstrategie | wie Erinnerung gefunden wird |
| Harness-Code | ausführbare Regel | wie das System künftig handelt |
Daraus folgt der zentrale Gedanke dieser Linie: Der Harness selbst kann Memory sein. Nicht nur Notizen speichern Erfahrung. Auch Toolsets, Hooks, Permissions, Mods, Verifier und Code speichern Erfahrung — sie ändern, was der Agent beim nächsten Mal tun kann.
5. Lernen vor der Anfrage
Ein Sprachmodell denkt normalerweise erst, wenn die Frage gestellt ist — und der Nutzer wartet, solange es denkt. Dieses Rechnen auf Zuruf heißt Test-Time Compute. Dabei liegt der Stoff, um den es gehen wird, meistens längst bereit: Ein Coding-Agent kennt die Codebasis, bevor der erste Bug gemeldet wird; ein Recherche-Agent hat seine Dokumente, ein persönlicher Assistent den bisherigen Gesprächsverlauf. Warum sollte diese Zeit ungenutzt verstreichen? Sleep-Time Compute dreht die Reihenfolge um: Der Agent denkt schon vorher über sein Material nach — in der Leerlaufzeit, in der ihn niemand braucht — und macht so aus Rohkontext (raw context) bereits gelernten Kontext (learned context): vorab gezogene Schlüsse, verdichtete Zusammenfassungen, aufbereitete Fakten.10
Formal: Aus dem Rohkontext c entsteht schon vor der Anfrage ein gelernter Kontext c', den das Modell später statt c verwendet. Der Gewinn liegt auf der Hand — ist die Vorarbeit getan, muss das Modell im Moment der Anfrage viel weniger nachdenken und kommt schneller und billiger zur gleichen Antwortqualität. In den Messungen des Sleep-Time-Papers genügt mit vorbereitetem Kontext rund ein Fünftel der sonst nötigen Rechenzeit zur Anfragezeit, um dieselbe Genauigkeit zu erreichen. Und die Vorarbeit ist keine Einmalausgabe: Beziehen sich viele Anfragen auf denselben Kontext, wird er einmal aufbereitet und immer wieder genutzt — die Kosten verteilen sich über alle Antworten.10
Das setzt eine Eigenschaft voraus, die einem Modell für sich fehlt: Zustand. Ein Sprachmodell ist von Haus aus zustandslos (stateless) — es behält nichts zwischen zwei Aufrufen, jeder beginnt bei null. Für ein solches Modell wäre jede Einsicht, die über Nacht entsteht, beim nächsten Aufruf wieder verloren. Sleep-Time Compute braucht deshalb zustandsbehaftete Agenten (stateful agents): Systeme mit einem Gedächtnis, das über die Zeit Bestand hat. Genau hier liegt Lettas Wette — Agenten nicht als Werkzeuge zu bauen, die auf Zuruf antworten und danach vergessen, sondern als zustandsbehaftete Systeme, die sich erinnern, fortlaufend lernen und mit der Zeit besser werden. Persistenter Zustand ist die Brücke, über die eine im Schlaf gewonnene Einsicht überhaupt in die nächste Aufgabe gelangt: keine Nebensache der Architektur, sondern ihre Voraussetzung.11
Architektonisch heißt das: Executor und Memory-Kurator trennen. Letta baut daraus ein Zwei-Agenten-Muster — ein Primary Agent spricht mit dem Nutzer, ein Sleep-Time Agent reorganisiert asynchron dessen Memory-Blöcke, gerne mit einem stärkeren, langsameren Modell, weil niemand wartet.11 Für dieses Verdichten von Erfahrung prägt Letta ein eigenes Bild: agent dreaming. Der Agent „träumt“ — er ordnet Erlebtes zu brauchbarer Erinnerung, so wie ein Gehirn im Schlaf den Tag verarbeitet.
Der Mechanismus trägt aber nur, wenn die Zukunft teilweise vorhersehbar ist — wenn sich also aus Repository, Dokument oder Verlauf ableiten lässt, worum es bei der nächsten Anfrage vermutlich geht. Der Coding-Agent kann das Repository studieren, bevor der Nutzer den konkreten Bug nennt; der persönliche Agent kann frühere Interaktionen konsolidieren, bevor die nächste Aufgabe kommt. Studiert der Agent aber das falsche Modul, oder fragt der Nutzer etwas völlig Kontextfremdes, ist die Sleep-Time-Arbeit verschwendet — dann wäre gewöhnliches Test-Time Compute die bessere Wahl gewesen.
Machine Studying verallgemeinert diese Idee. Ein Agent soll aus einem Korpus Expertise entwickeln, ohne die spätere Prüfaufgabe zu kennen. Expertise ist dabei präzise definiert: die Effizienz, mit der Inference Compute in richtige Arbeit verwandelt wird — gemessen als gewichtete Fläche unter der Leistungs-Kosten-Kurve, wobei günstige Rechenbudgets stärker zählen. Ein Anfänger mit Suchmaschine findet irgendwann eine richtige Antwort. Ein Experte findet sie mit weniger Aufwand und nutzt zusätzliche Rechenzeit besser.12
Die negativen Befunde der Arbeit sind dabei fast wichtiger als die positiven. Retrieval ist keine Expertise: Zwei Modelle können dieselbe Evidenz finden und sich trotzdem darin unterscheiden, welche Evidenz zählt. Und Memorisierung ist keine Expertise: Continual Pretraining auf dem Korpustext verbesserte die Expertise nicht. Der Korpus bleibt zur Testzeit ohnehin verfügbar. Der Punkt ist nicht, alles in Gewichte zu pressen. Der Punkt ist, den Zugriff auf den Korpus in dauerhafte, billige Kompetenz zu verwandeln — über Cheatsheets, Retrieval-Indizes, Skill-Dateien, Tests, Rubrics, Tool-Policies oder Harness-Code.
MetaClaw zeigt, wie das in einem deployten Agenten aussieht: Lernen auf zwei Zeitskalen. Nach Fehlschlägen schreibt ein Evolver sofort wirksame Skill-Dateien — schnelle Anpassung im Token-Raum, ohne Downtime. In Leerlauffenstern läuft opportunistisches LoRA-Finetuning — langsame Anpassung im Gewichtsraum. Entscheidend ist ein Datenvaliditäts-Protokoll: Trajektorien werden mit der Skill-Generation gestempelt, unter der sie entstanden; ändern sich die Skills, verfallen alte Samples, damit das Modell nicht gegen sein eigenes veraltetes Verhalten optimiert.13 Auch wann gelernt wird — Nachtstunden, Tastatur-Inaktivität, Kalenderlücken — ist hier eine Harness-Entscheidung.
Hinter all dem steht eine grundlegende Spannung, die Letta scharf benennt: Aufgabe erledigen und dauerhaft lernen sind oft konkurrierende Ziele. Ein Agent, der nur für den Abschluss der aktuellen Aufgabe belohnt wird, hat keinen Anreiz, Erfahrung für später aufzubauen — jedes Token, das ins Lernen für die Zukunft fließt, fehlt bei der Sache, die gerade zu erledigen ist. Am Coding-Agenten wird der Unterschied greifbar: Einen einzelnen Bug zu fixen ist eine Aufgabe; zu verstehen, welche Teile einer großen Codebasis besonders fehleranfällig sind und zusätzliche Tests verdienen, ist Lernen. Das heutige RL-Post-Training optimiert fast ausschließlich das Erste — die meisten Trainingsumgebungen behandeln jede Aufgabe als in sich abgeschlossen (stateless). Dauerhaftes Lernen ist deshalb kein Nebenprodukt besserer Modelle, sondern eine Entwurfsentscheidung: Man muss den Agenten ausdrücklich dafür bauen und belohnen, seinem künftigen Selbst brauchbaren Kontext zu hinterlassen.9
6. Lernen im Harness
AutoHarness ist der konkrete Wendepunkt.
Viele Agentenfehler sind keine tiefen Reasoning-Fehler. Sie sind Harness-Fehler. Als Gemini-2.5-Flash im Kaggle-GameArena-Schachturnier verlor, gingen 78 Prozent der Niederlagen nicht auf strategische Schwäche zurück, sondern auf illegale Züge.14 Ein Modell macht einen verbotenen Zug, ruft ein Tool im falschen Format auf oder verletzt eine Environment-Regel, die ein externer Checker trivial erkennen könnte. AutoHarness synthetisiert Code, der solche Regeln als ausführbare Kontrolle in den Harness verlagert.14
Das Verfahren behandelt Harness-Generierung als Programmsuche. Ein LLM schlägt Python-Funktionen wie propose_action() oder is_legal_action() vor. Tree Search mit Thompson Sampling entscheidet, welche Code-Hypothese verfeinert wird. Rollouts liefern Feedback: illegale Züge, Exceptions, Rewards. Das Modell ist nicht die Policy allein. Es ist auch ein Mutationsoperator für den Systemcode.
Die Modi sind technisch aufschlussreich:
| Modus | Rolle des Codes | Rolle des Modells |
|---|---|---|
| Action Filter | Code schlägt legale Aktionen vor | Modell wählt aus |
| Action Verifier | Code weist illegale Aktionen zurück | Modell versucht erneut |
| Harness-as-Policy | Code handelt direkt | Modell wird zur Trainingszeit genutzt |
Die starke Pointe: Ein kleineres Modell plus gelernter Harness kann ein größeres Modell ohne Harness schlagen. In den berichteten TextArena-Experimenten erreichen gelernte Verifier-Harnesses 100 Prozent Legal-Action-Success auf 145 Spielen. Gemini-2.5-Flash plus Harness schlägt in vielen Settings Gemini-2.5-Pro. Und Harness-as-Policy erreicht auf 16 Ein-Spieler-Spielen einen höheren Durchschnitts-Reward als Gemini-2.5-Pro und GPT-5.2-High — bei nahezu null Modellaufrufen zur Testzeit.14
Das Modell wurde dadurch nicht in seinen Gewichten klüger. Die Umgebung wurde besser operationalisiert. Wiederholte Fehler wurden zu Code. Environment-Regeln wurden aus dem unsicheren Weltmodell des LLMs in eine überprüfbare Systemschicht verschoben.
Meta-Harness macht daraus die allgemeinere Methode. Der Harness selbst wird optimiert. Ein Coding-Agent-Proposer liest eine Dateistruktur mit früheren Kandidaten, Ausführungstraces, Scores und Begründungen. Er schreibt neuen Harness-Code. Dieser wird evaluiert. Das Ergebnis wird zurück in die Historie geschrieben.15
Der entscheidende Unterschied zu vielen Optimierungsverfahren ist die volle diagnostische Geschichte. Nicht nur Score, nicht nur Zusammenfassung. Raw Traces, Code, Logs und Fehlschläge bleiben erhalten. In den Ablationen der Arbeit sind gerade diese rohen Execution Traces der wichtigste Bestandteil; Scores plus Zusammenfassungen sind deutlich schwächer. Fehlversuche werden zu experimenteller Evidenz. Der Proposer wertet diese Historie aus wie ein Experimentator seine Messreihen. In einem TerminalBench-Lauf etwa verschlechterte eine neue Harness-Version die Leistung. Weil diese Version aber zwei Dinge auf einmal geändert hatte — eine strukturelle Umstellung und einen neu formulierten Prompt —, ließ sich nicht sagen, welche der beiden Änderungen für den Einbruch verantwortlich war. Der Proposer erkannte diese Vermengung, prüfte die strukturelle Änderung anschließend isoliert und wählte für den nächsten Versuch die vorsichtigere Variante: eine Änderung, die nur etwas hinzufügt, statt Bestehendes zu ersetzen.
Zwei Ergebnisse stechen heraus. Erstens die Effizienz: In Online-Textklassifikation schlägt Meta-Harness Agentic Context Engineering um 7,7 Punkte — bei vierfach weniger Kontext-Tokens. Zweitens der Transfer: Ein einziger entdeckter Retrieval-Harness verbessert die Genauigkeit auf 200 Mathe-Problemen auf IMO-Niveau um 4,7 Punkte im Schnitt über fünf verschiedene Modelle — von denen keines bei der Optimierung des Harness verwendet worden war.15 Der zweite Befund ist der empirische Kern der ganzen These: Der gelernte Harness ist nicht an ein Modell gebunden. Er ist ein übertragbares Artefakt.
Dass eine Suche über den Systemaufbau selbst mehr bewirkt als das bloße Justieren von Stellschrauben, zeigt die AutoResearch-Linie drastisch. Herkömmliche automatische Optimierung dreht nur an vorgegebenen Reglern — Lernrate, Chunk-Größe, Anzahl der Suchtreffer — innerhalb eines fest verdrahteten Entwurfs. Ein autonomer Forschungsagent dagegen, der über 72 Stunden rund 50 Experimente an einem multimodalen Memory-System fährt, holt seine größten Gewinne aus Bereichen jenseits dieser Regler: ein Ein-Zeilen-Bugfix in einem API-Aufruf (ein fehlendes response_format), der die Antworten zuvor neunmal zu lang und damit unbrauchbar gemacht hatte; ein struktureller Umbau der Architektur; gezieltes Prompt-Engineering, etwa die Einsicht, dass es zählt, an welcher Stelle im Prompt eine Information steht. Jeder einzelne dieser Bereiche brachte mehr als alle Regler-Anpassungen zusammengenommen.16 Die wertvollsten Verbesserungen lagen also gar nicht im ursprünglichen Suchraum — die passende Optimierungsdimension musste der Agent erst selbst erfinden.
Damit wird der Harness zur lernenden Außenschicht des Modells:
flowchart TD
    T[Aufgabe] --> H[Harness]
    H --> M[Modell]
    M --> A[Aktion]
    A --> E[Environment]
    E --> O[Observation, Reward, Trace]
    O --> L[History: Code, Logs, Fehler, Scores]
    L --> P[Proposer]
    P --> H2[neuer Harness]
Das ist der Punkt, an dem der Begriff Meta-Harness Substanz bekommt. Der Harness ist nicht mehr nur Klebstoff zwischen Modell und Welt. Er ist ein Speicher für Erfahrung und ein Suchraum für Verbesserung.
7. Kontext als Environment
Zwei weitere Linien zeigen, dass auch Kontextmanagement selbst zu einer Agentenfähigkeit wird.
Context-Folding behandelt lange Agentenarbeit nicht als lineare Tokenkette. Der Agent kann mit branch(description, prompt) einen separaten Arbeitskontext öffnen und mit return(message) nur das Ergebnis zurück in den Hauptkontext falten. Zwischenschritte verschwinden aus dem aktiven Kontext, bleiben aber als lokale Arbeit erledigt. Der Effekt ist messbar: Mit 32K aktivem Kontext und bis zu zehn Branches erreicht der Folding Agent auf BrowseComp-Plus und SWE-Bench Verified Ergebnisse, die ReAct-Baselines mit 327K Kontext erreichen oder übertreffen — bei über 90 Prozent Kontextkompression im Hauptpfad.17
Zusammenfassen wäre zu wenig gesagt: Es ist eine per Reinforcement Learning trainierte Kontrollpolitik fürs Arbeitsgedächtnis. Der Agent lernt, welche Gedanken temporär sind, welche Resultate zurück in den Hauptpfad gehören und wie viel Kontextbudget eine Unteraufgabe verbrauchen darf.
Recursive Language Models setzen an einer ähnlichen Grenze an. Sehr lange Prompts werden nicht vollständig in das Modell gestopft, sondern als externe Ressource in einer REPL behandelt. Das Modell bekommt symbolische Handles, kann Slices inspizieren, Programme schreiben, Sub-Modelle aufrufen und Ergebnisse zusammensetzen. So werden Inputs jenseits von zehn Millionen Tokens bearbeitbar — weit über jedes Kontextfenster hinaus.18
Beide Ansätze trennen den semantischen Horizont vom neuronalen Kontextfenster. Der relevante Inhalt muss nicht vollständig im Prompt liegen. Er kann in der Welt liegen: als Datei, Variable, Suchraum oder rekursive Sub-Aufgabe. Der Harness gibt dem Modell die Griffe, um darauf zu operieren.
Das ist eine andere Antwort auf Long Context. Nicht: mehr Tokens in den Prompt. Sondern: bessere Operationen auf Kontext.
8. Was im Modell zurückkommt
Die Gegenbewegung existiert ebenfalls. Looped Language Models (LoopLM) wie Ouro skalieren Reasoning intern, indem sie Transformer-Blöcke rekurrent wiederverwenden. Das Modell kann mehr interne Tiefe auf schwierigere Inputs verwenden, ohne proportional mehr Parameter zu speichern. Die Zahlen sind beachtlich: Ouro-Modelle mit 1,4 und 2,6 Milliarden Parametern erreichen auf vielen Benchmarks das Niveau von SOTA-Modellen mit bis zu 12 Milliarden Parametern — und die kontrollierten Experimente legen nahe, dass der Gewinn aus besserer Wissensmanipulation stammt, nicht aus mehr Wissensspeicherung.19
Das ist der model-interne Gegenpart zu Harness-Schleifen. Meta-Harness externalisiert Wiederholung in Tools, Code, Memory und Traces. LoopLM internalisiert Wiederholung in latente Rechenschritte (latent reasoning). Beide Richtungen sagen dasselbe über die alte Ein-Schritt-Inferenz: Sie wird zu starr.
Diese Linie macht die Schlussfrage ernst. Wenn Modelle mehr Iteration, Tool-Nutzung, Memory-Formation und Kontextkontrolle internalisieren, schrumpft der äußere Harness. Ein Teil dessen, was heute als Prompt, Skill-Datei, Workflow oder Code-Guard gebaut wird, kann morgen Modellverhalten sein.
Aber nicht alles gehört in die Gewichte.
Gewichte sind schlecht für Rechteverwaltung. Sie sind schlecht für Auditierbarkeit. Sie sind schlecht für Rollback. Sie sind schlecht für harte Kostenlimits, rechtliche Grenzen, Zugriffskontrolle und reproduzierbare Tests. Ein Modell kann lernen, vorsichtiger zu handeln. Ein Harness kann verhindern, dass eine Aktion überhaupt ausführbar ist.
9. Grenzen
Meta-Harness ist keine magische Selbstverbesserung.
Erstens kann ein Harness an seinem Benchmark überfitten. Code-Space-Overfitting ist zwar sichtbarer als Weight-Space-Overfitting — man kann den Diff lesen —, aber nicht harmlos. Ein Harness kann die Form eines Tests lernen, ohne robuste Kompetenz zu erzeugen. Fast alle hier zitierten Selbstverbesserungs-Ergebnisse hängen zudem an schnellen, skalaren Offline-Evaluationen; reale Aufgabenströme liefern dieses Feedback selten so sauber.
Zweitens hängt die Suche am Proposer. Meta-Harness braucht einen starken Coding-Agenten, der aus Traces kausale Hypothesen bilden kann. Ein schwacher Proposer produziert Rauschen im Code-Raum statt Verbesserung.
Drittens ist Memory Formation schwerer als Retrieval. Viele Systeme speichern zu viel, zu wenig, zu allgemein oder zu spezifisch. Eine schlechte Erinnerung ist nicht neutral. Sie kann künftige Aktionen verschlechtern. Über lange Zeit kommt memory rot (Gedächtnis-Verfall) hinzu: Erinnerungen werden nach wiederholter Verdichtung generisch und verlustbehaftet oder kippen ins Überspezifische — die dauerhafte Entsprechung zum Context Rot.
Viertens kann Kontextkompression Information zerstören. Context-Folding hängt am return(message). Wenn diese Rückgabe falsche oder unvollständige Evidenz enthält, vergiftet sie den Hauptpfad.
Fünftens ist selbstmodifizierender Code ein Safety-Problem. Ein Harness, der seine Tools, Permissions oder Guards verändert, braucht Protokolle für Review, Rollback, Isolation und Audit. EvolveMem zeigt die Minimalform: Änderungen werden nur übernommen, wenn die Evaluation sich verbessert, und bei Regression automatisch zurückgerollt — der Guard ist das, was Selbstmodifikation von Chaos unterscheidet.8
Sechstens verschiebt Meta-Harness Kosten. Mehr Suche, mehr Sleep-Time Compute, mehr Verifier und mehr Traces können sichtbare Inferenzkosten senken und trotzdem Gesamtkosten erhöhen. Die relevante Metrik ist nicht Tokenzahl pro Antwort, sondern verifizierte Leistung pro vollständigem Systemlauf.
Diese Grenzen sprechen nicht gegen Meta-Harness. Sie bestimmen, wo der Begriff präzise bleibt. Ein Meta-Harness ist nur dann Lernen und nicht nur Automatisierung, wenn seine Änderungen außerhalb des Trainingsharness tragen.
10. Will the model eat the harness?
Man kann fragen, ob der Harness relativ zum Modell immer wichtiger wird. Die interessantere Frage aber lautet umgekehrt: Werden die Modelle das Übergangskonstrukt “Harness” bald ganz auffressen?
AutoHarness zeigt, warum die Frage überhaupt plausibel ist. Der gelernte Code-Harness enthält Regeln, die ein stärkeres Modell vielleicht irgendwann selbst stabil beachtet. Wenn ein Modell jede Environment-Regel versteht, jedes Toolformat einhält und jede illegale Aktion intern ausschließt, frisst es diesen Teil des Harness.
Gleichzeitig zeigt AutoHarness, warum die Frage nicht trivial ist. Der Harness tut Dinge, die nicht nur Intelligenz sind. Er beschränkt Aktionen. Er führt Code aus. Er weist Zugriffe zurück. Er schreibt Logs. Er prüft Ergebnisse. Er macht Fehler rekonstruierbar. Er hält Erfahrung als Code fest.
Und es gibt ein empirisches Argument gegen das vollständige Fressen: Der Meta-Harness-Transfer über fünf ungesehene Modelle und die Letta-Ökonomie der Memory zeigen dasselbe Muster von zwei Seiten. Modelle werden ausgetauscht; gelernte Harness- und Memory-Artefakte akkumulieren über Modellgenerationen hinweg. Was das Modell frisst, muss beim nächsten Modellwechsel neu gelernt werden. Was im Harness lebt, zieht einfach um.
Die Grenze wird deshalb nicht verschwinden. Sie wird wandern.
| Frage | Wahrscheinlicher Ort |
|---|---|
| Muster erkennen | Modell |
| temporär adaptieren | Kontext |
| Erfahrung behalten | Memory |
| Tools ausführen | Harness |
| Rechte begrenzen | Harness |
| Erfolg prüfen | Verifier |
| Verhalten dauerhaft ändern | Gewichte, Memory oder Harness |
Modelle werden Teile des Harness internalisieren. Mehr Tool-Nutzung, mehr Planungsdisziplin, mehr Kontextkontrolle und mehr latentes Reasoning wandern ins Modell. Aber die äußere Schicht bleibt dort stark, wo Handeln Folgen hat: Ausführung, Rechte, Verifikation, Kosten, Audit und persistente Erfahrung.
Hier schließt sich der Bogen zu 1987. Die Gödel Machine wollte Selbstmodifikation mit Beweis; praktikabel war das nie. Der Meta-Harness ist die pragmatische Einlösung: Selbstmodifikation als Code-Diff, mit Trace-Log statt Beweis, mit Guard statt Theorem — inspizierbar, rollbackfähig, auditierbar.
Die nächste Agentenarchitektur entscheidet deshalb nicht nur, wie und wie lange das Modell denkt. Sie entscheidet, was das Modell selbst lernen darf, was der Kontext tragen kann, was Memory behalten soll und was im Harness überprüfbar bleiben muss. Die essenzielle Meta-Harness-Frage lautet somit: Wo soll Lernen leben, damit ein Agent besser wird, ohne unkontrollierbar zu werden?
Postscriptum: Harness-Landscape Juli 2026
Dieses Postscriptum ordnet die wichtigsten Agent-Frameworks nach ihrem Kontrollpunkt im System. Entscheidend ist die Trennung zwischen Agent-Orchestration und Harness-Orchestration: Koordiniert ein Produkt nur mehrere Agenten, oder kontrolliert es auch Ausführung, Rechte, Zustand, Kosten und Nachweisbarkeit? Die Matrix zeigt, welche Schicht ein Anbieter im Juli 2026 besetzt.20
| Begriff | Grenze |
|---|---|
| Agent | Entscheidet den nächsten Schritt: planen, Tool wählen, Antwort geben. |
| Agent-Orchestration | Koordiniert mehrere Agenten, Rollen oder Handoffs. Es ist Arbeitsteilung. |
| Harness | Macht Handeln ausführbar: Kontext, Tools, Sandbox, Memory, Rechte, Logs, Eval. |
| Harness-Orchestration | Koordiniert diese Ausführungsschicht über Sessions, Tools, Policies, Kosten und Traces. |
| Meta-Harness | Databricks: Schicht über fremden Harnesses. Dieser Text: Optimierungsschleife für den Harness selbst. |
| Player | Positionierung | Lesart |
|---|---|---|
| Databricks Omnigent21 | Common API über Claude Code, Codex, Pi und eigene Agents; dazu Policies, Sharing, Collaboration. | Meta-Control über bestehende Harnesses. |
| Pi22 | Minimaler Agent-Harness, der sich über Extensions, Skills, Templates und Packages anpassen lässt. | Developer-owned Harness. |
| OpenClaw23 | Lokaler, always-on Personal Agent über Messenger, mit Skills, Memory und Integrationen. | Personal-OS-Harness; Agent und Harness verschmelzen. |
| Nous Hermes Agent24 | Cross-surface Assistant mit persistentem Memory, Auto-Skills, Subagents und Sandbox. | Kommerzialisierter Personal-Harness. |
| Letta9 | Memory-native Agents, die lernen, indem sie dauerhaften Kontext schreiben. | Memory ist der Control Point. |
| CrewAI25 | Multi-Agent-Workflows, Control Plane, Tracing, RBAC, Training und Evals. | Workflow-Automation wird Agentenplattform. |
| LangGraph / LangSmith26 | Stateful Graphs, Deployment, Observability, Evals, Sandboxes und Agent Management. | Graph-Orchestration wird Runtime-Harness. |
| OpenAI Agents SDK27 | Kleine Primitives: Agents, Handoffs, Guardrails, Sessions, Tracing, Sandbox Agents. | Provider-naher Agent Loop. |
| Google ADK / Agent Platform28 | Open ADK, Graph Workflows, Multi-Agent Workflows, Runtime, Evals, Security. | Hyperscaler-Harness um Gemini und offene Modelle. |
| AWS Strands / AgentCore2930 | Open SDK plus managed Harness, Runtime, Memory, Gateway, Policy, Registry und Optimization. | Die expliziteste Harness-Kommerzialisierung. |
| Microsoft AutoGen / Semantic Kernel31 | Conversational Multi-Agent Apps, Event Core, Process Orchestration, Enterprise-Integration. | Agent-Orchestration im Microsoft-Stack. |
| LlamaIndex / Pydantic AI3233 | Agentic RAG, Workflows, typed Tools, Evals, Observability, Durable Execution. | Spezial-Harnesses für Wissen und Python-Typen. |
Agent-Orchestration ordnet Arbeitsteilung. Harness-Orchestration ordnet Handlungsmacht. Die erste Frage gehört zur Application Logic: Welche Rolle übernimmt welchen Teil? Die zweite Frage gehört zu Betriebssystem, Cloud, Security und Audit: Welche Aktion darf überhaupt passieren?
Der Begriff Meta-Harness hat deshalb zwei Bedeutungen. Databricks legt ihn oberhalb bestehender Agent-Harnesses: kombinieren, steuern, teilen. Dieser Text legt ihn um den Harness herum: beobachten, verändern, evaluieren. Die gemeinsame Bewegung: Modellwahl verliert als Differenzierung; Runtime-Eigentum gewinnt.
Runtime-Eigentum heißt: Wer kontrolliert Sandbox, Tool-Gateway, Rechte, Memory-Store, Trace-Log, Eval-Harness und Deployment-Oberfläche? Databricks besetzt die Kontrollschicht über fremden Agents. AWS besetzt die Managed Runtime. LangGraph besetzt Graph, State und Observability. Pi, OpenClaw und Nous ziehen den Harness auf das lokale oder persönliche System.
So werden die Anbieterpositionen lesbar. Frameworks beschleunigen Bau. Plattformen kontrollieren Lauf. Meta-Harnesses sichern Portabilität. Sessions, Skills, Policies, Memory und Traces sollen mitwandern, wenn Modell oder Agent wechseln. Das gibt offenen Modellen Rückenwind: Je portabler der Harness, desto austauschbarer wird das Modell.
Quellen und weiterführende Literatur
Die Linie beginnt bei klassischem Meta-Learning (Schmidhuber, MAML, RL²) und führt über In-Context-Learning, Memory-Systeme (MemGPT, SimpleMem, EvolveMem, Memory Models), Sleep-Time Compute, Machine Studying und Compound AI Systems zu AutoHarness und Meta-Harness. Context-Folding und Recursive Language Models zeigen Kontextmanagement als Agentenfähigkeit; LoopLM liefert den model-internen Kontrast; MetaClaw und die AutoResearch-Linie zeigen deployte beziehungsweise forschende Harnesses in Aktion.
Footnotes
-
Matei Zaharia, Omar Khattab, Lingjiao Chen, Jared Quincy Davis, Heather Miller, Chris Potts, James Zou, Michael Carbin, Jonathan Frankle, Naveen Rao, Ali Ghodsi, The Shift from Models to Compound AI Systems, Berkeley Artificial Intelligence Research Blog, 18. Februar 2024. https://bair.berkeley.edu/blog/2024/02/18/compound-ai-systems/ ↩
-
Jürgen Schmidhuber, Metalearning Machines Learn to Learn (1987–), 2020, laufend aktualisiert. https://people.idsia.ch/~juergen/metalearning.html ↩
-
Chelsea Finn, Pieter Abbeel, Sergey Levine, Model-Agnostic Meta-Learning for Fast Adaptation of Deep Networks, Proceedings of the 34th International Conference on Machine Learning, PMLR 70:1126-1135, 2017. https://proceedings.mlr.press/v70/finn17a.html ↩
-
Yan Duan, John Schulman, Xi Chen, Peter L. Bartlett, Ilya Sutskever, Pieter Abbeel, RL²: Fast Reinforcement Learning via Slow Reinforcement Learning, arXiv:1611.02779, 2016. https://arxiv.org/abs/1611.02779 ↩
-
Johannes von Oswald, Eyvind Niklasson, Ettore Randazzo, João Sacramento, Alexander Mordvintsev, Andrey Zhmoginov, Max Vladymyrov, Transformers Learn In-Context by Gradient Descent, Proceedings of the 40th International Conference on Machine Learning, PMLR 202:35151-35174, 2023. https://proceedings.mlr.press/v202/von-oswald23a.html ↩
-
Charles Packer, Sarah Wooders, Kevin Lin, Vivian Fang, Shishir G. Patil, Ion Stoica, Joseph E. Gonzalez, MemGPT: Towards LLMs as Operating Systems, arXiv:2310.08560, 2023. https://arxiv.org/abs/2310.08560 ↩
-
Jiaqi Liu, Yaofeng Su, Peng Xia, Siwei Han, Zeyu Zheng, Cihang Xie, Mingyu Ding, Huaxiu Yao, SimpleMem: Efficient Lifelong Memory for LLM Agents, arXiv:2601.02553, 2026. https://arxiv.org/abs/2601.02553 ↩
-
Jiaqi Liu, Xinyu Ye, Peng Xia, Zeyu Zheng, Cihang Xie, Mingyu Ding, Huaxiu Yao, EvolveMem: Self-Evolving Memory Architecture via AutoResearch for LLM Agents, arXiv:2605.13941, 2026. https://arxiv.org/abs/2605.13941 ↩ ↩2
-
Letta, Memory Models: Towards Agents That Learn, Letta Blog, 25. Juni 2026. https://www.letta.com/blog/towards-agents-that-learn/ ↩ ↩2 ↩3 ↩4
-
Kevin Lin, Charlie Snell, Yu Wang, Charles Packer, Sarah Wooders, Ion Stoica, Joseph E. Gonzalez, Sleep-time Compute: Beyond Inference Scaling at Test-time, arXiv:2504.13171, 2025. https://arxiv.org/abs/2504.13171 ↩ ↩2
-
Letta, Sleep-time Compute, Letta Blog, 21. April 2025. https://www.letta.com/blog/sleep-time-compute/ ↩ ↩2
-
Jacob Xiaochen Li, Rick Battle, Omar Khattab, Machine Studying, 17. Juni 2026. https://jacobxli.com/blog/2026/machine-studying/ ↩
-
Peng Xia, Jianwen Chen, Xinyu Yang, Haoqin Tu, Jiaqi Liu, Kaiwen Xiong, Siwei Han, Shi Qiu, Haonian Ji, Yuyin Zhou, Zeyu Zheng, Cihang Xie, Huaxiu Yao, MetaClaw: Just Talk — An Agent That Meta-Learns and Evolves in the Wild, arXiv:2603.17187, 2026. https://arxiv.org/abs/2603.17187 ↩
-
Xinghua Lou, Miguel Lazaro-Gredilla, Antoine Dedieu, Carter Wendelken, Wolfgang Lehrach, Kevin P. Murphy, AutoHarness: Improving LLM Agents by Automatically Synthesizing a Code Harness, arXiv:2603.03329, 2026. https://arxiv.org/abs/2603.03329 ↩ ↩2 ↩3
-
Yoonho Lee, Roshen Nair, Qizheng Zhang, Kangwook Lee, Omar Khattab, Chelsea Finn, Meta-Harness: End-to-End Optimization of Model Harnesses, arXiv:2603.28052, 2026. https://arxiv.org/abs/2603.28052 ↩ ↩2
-
Jiaqi Liu, Zipeng Ling, Shi Qiu, Yanqing Liu, Siwei Han, Peng Xia, Haoqin Tu, Zeyu Zheng, Cihang Xie, Charles Fleming, Mingyu Ding, Huaxiu Yao, Omni-SimpleMem: Autoresearch-Guided Discovery of Lifelong Multimodal Agent Memory, arXiv:2604.01007, 2026. https://arxiv.org/abs/2604.01007 ↩
-
Weiwei Sun, Miao Lu, Zhan Ling, Kang Liu, Xuesong Yao, Yiming Yang, Jiecao Chen, Scaling Long-Horizon LLM Agent via Context-Folding, arXiv:2510.11967, 2025. https://arxiv.org/abs/2510.11967 ↩
-
Alex L. Zhang, Tim Kraska, Omar Khattab, Recursive Language Models, arXiv:2512.24601, 2025. https://arxiv.org/abs/2512.24601 ↩
-
Rui-Jie Zhu, Zixuan Wang, Kai Hua, Tianyu Zhang, Ziniu Li, Haoran Que, Boyi Wei, Zixin Wen, Fan Yin, He Xing, Lu Li, Jiajun Shi, Kaijing Ma, Shanda Li, Taylor Kergan, Andrew Smith, Xingwei Qu, Mude Hui, Bohong Wu, Qiyang Min et al., Scaling Latent Reasoning via Looped Language Models, arXiv:2510.25741, 2025. https://arxiv.org/abs/2510.25741 ↩
-
Hailin Zhong, Shengxin Zhu, AI Harness Engineering: A Runtime Substrate for Foundation-Model Software Agents, arXiv:2605.13357, 2026; Interloom, Harness Engineering: Matching Agents to Work, 2026. https://arxiv.org/abs/2605.13357 und https://interloom.com/en/blog/harness-engineering-matching-agents-to-work/ ↩
-
Matei Zaharia, Kasey Uhlenhuth, Corey Zumar, Introducing Omnigent: A Meta-Harness to Combine, Control and Share Your Agents, Databricks Blog, 13. Juni 2026. https://www.databricks.com/blog/introducing-omnigent-meta-harness-combine-control-and-share-your-agents ↩
-
Pi Coding Agent, Pi — Make it yours, 2026. https://pi.dev/ ↩
-
OpenClaw, The AI that really does things, 2026. https://openclaw.ai/ ↩
-
Nous Research, Hermes Agent, 2026. https://hermes-agent.nousresearch.com/ ↩
-
CrewAI, CrewAI, 2026. https://crewai.com/ ↩
-
LangChain, LangGraph Platform is now Generally Available: Deploy & manage long-running, stateful Agents, 14. Mai 2025; LangChain Docs, LangSmith Deployment, 2026. https://www.langchain.com/blog/langgraph-platform-ga und https://docs.langchain.com/langsmith/deployment ↩
-
OpenAI, OpenAI Agents SDK, 2026. https://openai.github.io/openai-agents-python/ ↩
-
Google, Agent Development Kit (ADK), 2026. https://adk.dev/ ↩
-
Clare Liguori, Introducing Strands Agents, an Open Source AI Agents SDK, AWS Open Source Blog, 2026. https://aws.amazon.com/blogs/opensource/introducing-strands-agents-an-open-source-ai-agents-sdk/ ↩
-
Amazon Web Services, Amazon Bedrock AgentCore Overview, 2026. https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/what-is-bedrock-agentcore.html ↩
-
Microsoft, AutoGen Documentation, 2026; Microsoft Learn, Semantic Kernel Agent Framework, 2025. https://microsoft.github.io/autogen/stable/ und https://learn.microsoft.com/en-us/semantic-kernel/frameworks/agent/ ↩
-
LlamaIndex, Agents, Developer Documentation, 2026. https://developers.llamaindex.ai/python/framework/use_cases/agents/ ↩
-
Pydantic, Pydantic AI, 2026. https://pydantic.dev/docs/ai/overview/ ↩