Kurzfassung
Man hört oft, chinesische Open-Source-Labs hätten ihre Modelle von Anthropic oder OpenAI destilliert. Der Satz wirft mehrere Verfahren zusammen. Wer Antworten eines Frontier-Modells sammelt und darauf finetunt, betreibt in der Regel Off-Policy-Distillation: Der Teacher erzeugt die Zielsequenzen, der Student imitiert sie. On-Policy Distillation (OPD) dreht die Datenquelle um. Der Student erzeugt seine eigenen Sequenzen; der Teacher bewertet auf jedem dieser Pfade, welche Token er selbst für wahrscheinlich hält.1
Das Verfahren verbindet zwei Eigenschaften, die im üblichen LLM-Post-Training getrennt auftreten. Wie beim Reinforcement Learning stammen die Trajektorien aus der aktuellen Student-Policy. Wie beim Supervised Finetuning entsteht an jedem Token ein Lernsignal. Die praktische Folge lässt sich präzise benennen: Eine Sammlung guter Teacher-Antworten reicht für Off-Policy-SFT. On-Policy Distillation mit Reverse KL verlangt Zugriff auf die Wahrscheinlichkeiten des Teachers für die vom Student-Modell erzeugten Token.
Zwei Achsen erklären die Tabelle
Sampling bezeichnet, aus welcher Policy die Trainingssequenzen stammen. On-policy heißt: Der aktuelle Student erzeugt die Sequenzen selbst. Off-policy heißt: Sie stammen aus einer anderen Quelle, etwa vom Teacher, von Menschen oder aus einem festen Datensatz. Dicht ist ein Lernsignal an jedem Token. Spärlich ist typischerweise ein Reward für die ganze Sequenz. Der Tabellenkopf verwendet Reward-Signal als Sammelbegriff; bei SFT ist es der überwachte Token-Loss.
| Methode | Sampling | Reward-Signal |
|---|---|---|
| Supervised Finetuning | off-policy | dicht |
| Reinforcement Learning | on-policy | spärlich |
| On-Policy Distillation | on-policy | dicht |
Supervised Finetuning. Der Student sieht eine vorgegebene Zielsequenz. Teacher Forcing setzt an jeder Position den korrekten bisherigen Zieltext in den Kontext; die Cross-Entropy liefert für jedes nächste Token einen Gradienten. Bei Teacher-generierten Daten ist das eine Stichprobenschätzung der Forward KL, also . Klassische Knowledge Distillation nutzt weiche Teacher-Wahrscheinlichkeiten. Sie transportieren mehr Struktur als ein einzelnes hartes Label.2
Der Trainingspfad unterscheidet sich dabei vom späteren Einsatz. Bei der Inferenz liest der Student seine eigenen bisherigen Token. Ein früher Fehler führt in Kontexte, die im festen Teacher-Datensatz selten oder gar nicht vorkommen. Dadurch können sich Fehler über lange Sequenzen verstärken. DAgger formulierte das Grundproblem für sequenzielles Imitation Learning: Trainiert werden sollte auf den Zuständen, die die gelernte Policy selbst besucht.3
Reinforcement Learning. Die aktuelle Policy erzeugt Rollouts und erfüllt damit die On-Policy-Bedingung. In vielen Reasoning-Setups kommt der Reward erst am Ende: Antwort richtig oder falsch, Test bestanden oder fehlgeschlagen. Das Signal bewertet die eigene Trajektorie, lokalisiert den entscheidenden Token jedoch nicht. Die Tabellenzeile beschreibt diesen verbreiteten Einsatz mit Outcome-Verifier. RL kann technisch auch dichte Prozess-Rewards verwenden.
On-Policy Distillation. Der Student sampelt seine Trajektorie. Der Teacher bewertet anschließend an jedem Student-Präfix die nächste Aktion. So lernt der Student in den Kontexten, die seine eigenen Entscheidungen tatsächlich erzeugen, einschließlich seiner typischen Abzweigungen und Fehler. GKD übertrug diese Logik explizit auf autoregressive Sprachmodelle und verband Student-generierte Sequenzen mit frei wählbaren Divergenzen zwischen Teacher und Student.4
Der praktische Reiz liegt in der Trainingseffizienz: Weil jedes Token ein Signal trägt statt nur die fertige Sequenz, erreichte ein Qwen3-8B-Student bei Thinking Machines Lab das AIME-2024-Niveau seines Qwen3-32B-Teachers mit rund sieben- bis zehnmal weniger Gradient-Steps als RL mit Outcome-Reward. Wie stark sich das in Rechenkosten übersetzt, hängt vom Aufbau ab; Thinking Machines Lab nennt je nach Annahme einen Faktor zwischen 9 und 30.1
Die Loss-Funktion: Reverse KL
Sei der bisherige, vom Student-Modell erzeugte Text. Für das nächste Token definiert der Student die Verteilung , der Teacher die Verteilung . Der Loss pro Token ist die Reverse-KL-Divergenz:
Reverse bezeichnet die Reihenfolge der Argumente: Links steht der Student , rechts der Teacher . Beim üblichen SFT steht die Teacher-Verteilung vorn. Was die Reihenfolge bewirkt, zeigt die rechte Seite der Gleichung: Das Subskript besagt, dass über Token gemittelt wird, die der Student selbst gezogen hat. Er bestimmt damit, welche Token und Präfixe bewertet werden; beim SFT übernimmt diese Rolle der feste Teacher-Datensatz.
Die einfache Implementierung besteht aus vier Schritten:
- Der Student sampelt zu einem Prompt eine frische Trajektorie und speichert seine Log-Probabilities.
- Der Teacher berechnet auf genau dieser Trajektorie .
- Für jedes gezogene Token dient als Advantage — die vorzeichenumgekehrte Stichprobenschätzung des Reverse-KL-Terms.
- Ein Policy-Gradient-Update nutzt , um die Gewichte des Students anzupassen. Gibt der Teacher dem gezogenen Token mehr Wahrscheinlichkeit als der Student, ist positiv und steigt. Andernfalls sinkt die Wahrscheinlichkeit dieses Tokens nach diesem Präfix. Stammt die Trajektorie aus einer inzwischen überholten Policy, korrigiert Importance Sampling die Differenz.
Zwei Eigenschaften dieses Signals sind entscheidend. Erstens wird jedes Token einzeln bewertet und einzeln korrigiert; sein Wert hängt nicht davon ab, wie die Sequenz weitergeht. Genau das nennt die Tabelle ein dichtes Signal.1 Zweitens ist nur eine Schätzung: Exakt müsste man an jeder Position über das gesamte Vokabular summieren, gewichtet mit den Wahrscheinlichkeiten des Students, und das verlangt die vollständigen Teacher-Logits. Schritt 3 begnügt sich mit dem einen Token, das der Student tatsächlich gezogen hat — ungenauer pro Position, verlangt vom Teacher aber nur eine einzige Zahl.
Bleibt die Frage, warum Reverse KL und nicht die Forward KL des SFT. MiniLLM führt die Antwort auf die begrenzte Kapazität des Students zurück: Die beiden Richtungen bestrafen entgegengesetzte Fehler. Die Forward KL fällt hoch aus, wenn der Student einer Fortsetzung wenig Wahrscheinlichkeit gibt, die der Teacher für plausibel hält. Er muss deshalb viele Möglichkeiten offenhalten und verteilt seine Wahrscheinlichkeit auf mehr Kandidaten. Die Reverse KL bestraft stattdessen Wahrscheinlichkeitsmasse auf Fortsetzungen, die der Teacher für unwahrscheinlich hält. Plausible Teacher-Fortsetzungen, denen der Student praktisch keine Wahrscheinlichkeit gibt, werden im Loss kaum gewichtet. Der Student konzentriert sich deshalb auf wenige Fortsetzungen, die auch der Teacher für plausibel hält.5
Reverse KL hat zugleich eine Startbedingung. Der Student muss brauchbare Verhaltensweisen mit praktisch relevanter Wahrscheinlichkeit sampeln können. Erzeugt er ein Verhalten praktisch nie, liefern seine Trajektorien dafür kein Trainingssignal. In der Praxis steht deshalb häufig SFT oder Mid-Training vor der On-Policy-Phase: Forward-KL-Training erschließt Verhalten; Reverse-KL-Training schärft es auf den Zuständen des Student-Modells.
Was der Begriff praktisch ausschließt
Eine Text-API, die nur fertige Teacher-Antworten zurückgibt, eignet sich für synthetische Trainingsdaten und Off-Policy-SFT. Die beschriebene Reverse-KL-Implementierung braucht mehr: Der Teacher muss die Student-Trajektorie tokenweise mit Wahrscheinlichkeiten bewerten können. Die einfache Variante setzt außerdem ein gemeinsames oder sauber abbildbares Token-Vokabular voraus. Solange eine Frontier-API keine Token-Wahrscheinlichkeiten für fremd erzeugte Sequenzen zurückgibt, bleibt der Weg über sie off-policy — unabhängig davon, wie gut die synthetischen Daten sind.
Das dichte Signal bleibt an die Qualität des Teachers gebunden. Es sagt an jeder Position, wie wahrscheinlich der Teacher das nächste Token nach dem jeweiligen Präfix hält. Es beweist weder faktische Richtigkeit noch den Erfolg der gesamten Sequenz. Externe Verifier oder Outcome-Rewards können diese Lücke ergänzen. Student-Kapazität, Promptverteilung und Teacher-Fehler begrenzen weiterhin, was übertragen wird.
Auch on-policy ist eine Frischebedingung. Nach mehreren Updates stammen alte Rollouts aus einer früheren Policy. Ein Trainingssystem muss laufend neu sampeln, veraltete Daten begrenzen oder ihre Abweichung von der aktuellen Policy per Importance Sampling korrigieren.
Vom Spezialisten zum fertigen Modell
Der wichtigste offen dokumentierte Einsatz von On-Policy Distillation ist die Zusammenführung spezialisierter Modelle. Alle Spezialisten werden vom selben Ausgangsmodell abgeleitet. Jeder erhält einen eigenen Datenmix, eigene Rewards und ein passendes Reasoning- oder Kontextbudget. Anschließend lernt ein gemeinsames Student-Model (das finale Modell in spe) auf seinen eigenen Trajektorien vom jeweils passenden Spezialisten.
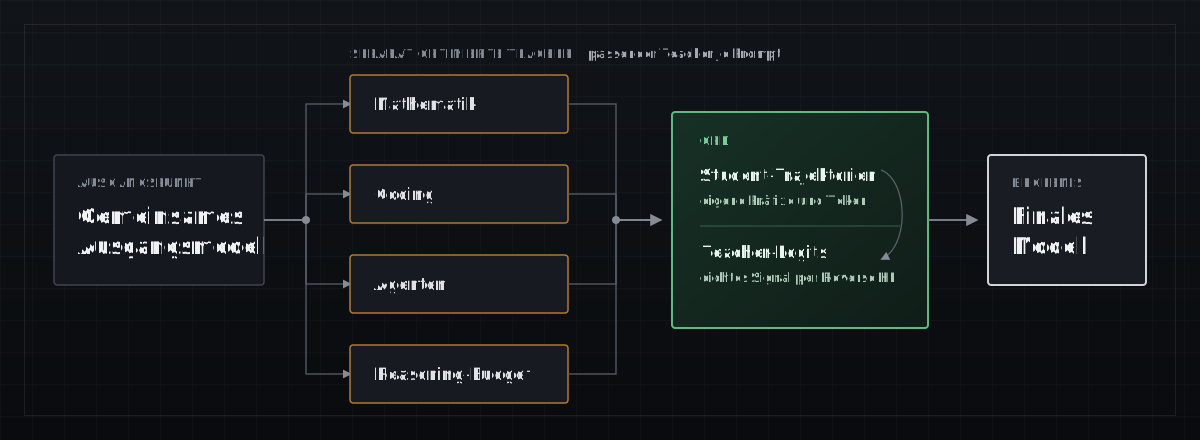
In einem gemischten RL-Lauf konkurrieren Coding, Mathematik, Tool Use und allgemeine Antworten um dieselben Modell-Updates. Auch ihre Rewards, Rollout-Längen und Rechenbudgets unterscheiden sich. Separate Spezialisten entkoppeln diese Optimierungsziele. On-Policy Distillation überträgt ihre Tokenverteilungen anschließend in einen gemeinsamen Parametersatz, um das finale Modell zu bauen. Im Betrieb geht dann nur dieses eine finale Modell; die Teacher werden nur im Training benötigt. Auswahl, Promptmix und Gewichtung der Teacher bestimmen, wie stark die einzelnen Fähigkeiten im fertigen Modell erhalten bleiben.
| System | Teacher | Einsatz der On-Policy Distillation |
|---|---|---|
| DeepSeek V4 | Domänenspezialisten sowie eigene Modelle für Non-Think, Think High und Think Max; mehr als zehn Teacher in der OPD-Stufe | OPD ersetzt die frühere Mixed-RL-Stufe vollständig und führt die Spezialisten zusammen. DeepSeek berechnet die Reverse KL über das volle Vokabular, um die Varianz einer Stichprobenschätzung anhand einzelner Token zu vermeiden.6 |
| Kimi K3 | Drei Domänen — allgemeine Aufgaben, Agentenaufgaben und Coding-Agenten — gekreuzt mit low, high und max: neun Teacher | Der finale Checkpoint lernt je nach Domäne und angefordertem Reasoning-Budget vom passenden Spezialisten. Ein Modell kann damit mehrere Domänen und Reasoning-Budgets bedienen.7 |
| GLM-5 | Checkpoints aus früheren SFT- und RL-Phasen | Die letzte OPD-Phase stellt Fähigkeiten wieder her, die bei späteren RL-Phasen geschwächt wurden. Interleaved, Preserved und Turn-Level Thinking werden zuvor per SFT eingeführt.8 |
| Qwen3 | Qwen3-32B oder Qwen3-235B-A22B als Teacher für Modelle von 0,6B bis 30B-A3B | Nach einem Off-Policy-Start gleicht OPD die Logitverteilungen auf den eigenen Student-Trajektorien an die des Teachers an. Die zweistufige Distillation ersetzt die vierstufige Post-Training-Pipeline und überträgt die Fähigkeit, zwischen Thinking und Non-Thinking zu wechseln. Für Qwen3-8B berichtet das Team etwa ein Zehntel der GPU-Stunden eines vergleichbaren RL-Laufs.9 |
DeepSeek V4 und Kimi K3 führen parallele Spezialisten zusammen. GLM-5 wendet denselben Mechanismus über Trainingsphasen hinweg an: Frühere Checkpoints werden zu Teachern, damit spätere Phasen vorhandene Fähigkeiten nicht dauerhaft verdrängen. Qwen3 überträgt die Fähigkeiten großer Teacher-Modelle auf kleinere Modelle derselben Familie.
Zwei aktuelle Preprints untersuchen weitere Anwendungen. Guided-OPD zieht die Hilfe des Teachers in langen Agenten-Rollouts schrittweise zurück und begrenzt so frühe Fehlerketten.10 Direct-OPD überträgt die von RL gelernte Verteilungsänderung eines kleinen Modells auf ein größeres Student-Modell.11 Beide Ansätze sind bisher Forschungsprototypen. Bei den Verfahren in der Tabelle berichten die Teams bereits über den Einsatz in vollständigen Modelltrainings.
Wer eine Meldung über „destillierte“ Frontier-Fähigkeiten einordnen will, braucht daher drei Angaben: Wer erzeugte die Trajektorien? Konnte der Teacher die Token des Students mit Log-Probabilities bewerten? Wurde Forward KL per SFT oder Reverse KL auf Student-Rollouts optimiert? Erst diese Antworten trennen synthetisches Finetuning von On-Policy Distillation.
Quellen und weiterführende Literatur
Ausgangspunkt ist der Beitrag von Thinking Machines Lab. Die Grundlagen decken Knowledge Distillation, On-Policy Imitation Learning und Reverse-KL-Distillation für autoregressive Sprachmodelle ab. Die aktuellen Anwendungsbeispiele stammen aus den technischen Berichten der jeweiligen Modellteams.
Footnotes
-
Kevin Lu und Thinking Machines Lab, On-Policy Distillation, 27. Oktober 2025. https://thinkingmachines.ai/blog/on-policy-distillation/ ↩ ↩2 ↩3
-
Geoffrey Hinton, Oriol Vinyals, Jeff Dean, Distilling the Knowledge in a Neural Network, 2015. https://arxiv.org/abs/1503.02531 ↩
-
Stéphane Ross, Geoffrey J. Gordon, J. Andrew Bagnell, A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning, AISTATS 2011. https://proceedings.mlr.press/v15/ross11a.html ↩
-
Rishabh Agarwal et al., On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes, ICLR 2024. https://arxiv.org/abs/2306.13649 ↩
-
Yuxian Gu, Li Dong, Furu Wei, Minlie Huang, MiniLLM: On-Policy Distillation of Large Language Models, ICLR 2024 (dort unter dem Titel Knowledge Distillation of Large Language Models). https://arxiv.org/abs/2306.08543 ↩
-
DeepSeek-AI et al., DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence, 2026, Abschnitte 5.1.1 und 5.1.2. https://arxiv.org/abs/2606.19348 ↩
-
Kimi Team, Kimi K3: Open Frontier Intelligence, 2026, Abschnitte 4.1.2 und 4.1.3. https://arxiv.org/abs/2607.24653 ↩
-
GLM-5 Team, GLM-5: from Vibe Coding to Agentic Engineering, 2026, Abschnitte 3.1 und 3.5. https://arxiv.org/abs/2602.15763 ↩
-
Qwen Team, Qwen3 Technical Report, 2025, Abschnitte 4.5 und 4.7. https://arxiv.org/abs/2505.09388 ↩
-
Gengsheng Li et al., On-Policy Distillation with Curriculum Turn-level Guidance for Multi-turn Agents, 2026. https://arxiv.org/abs/2606.15912 ↩
-
Shiyuan Feng et al., Weak-to-Strong Generalization via Direct On-Policy Distillation, 2026. https://arxiv.org/abs/2607.05394 ↩